AIに手伝ってもらって書いた文章を、公開前に読み返しました。三回ほど目を通しています。
それでも、見落としていました。
文章の中に、韓国語とロシア語の単語が混ざっていたんです。
こういうものです
実際に出てきたものを、そのまま並べます。
개발の記録
устройства の使い方
안심してください
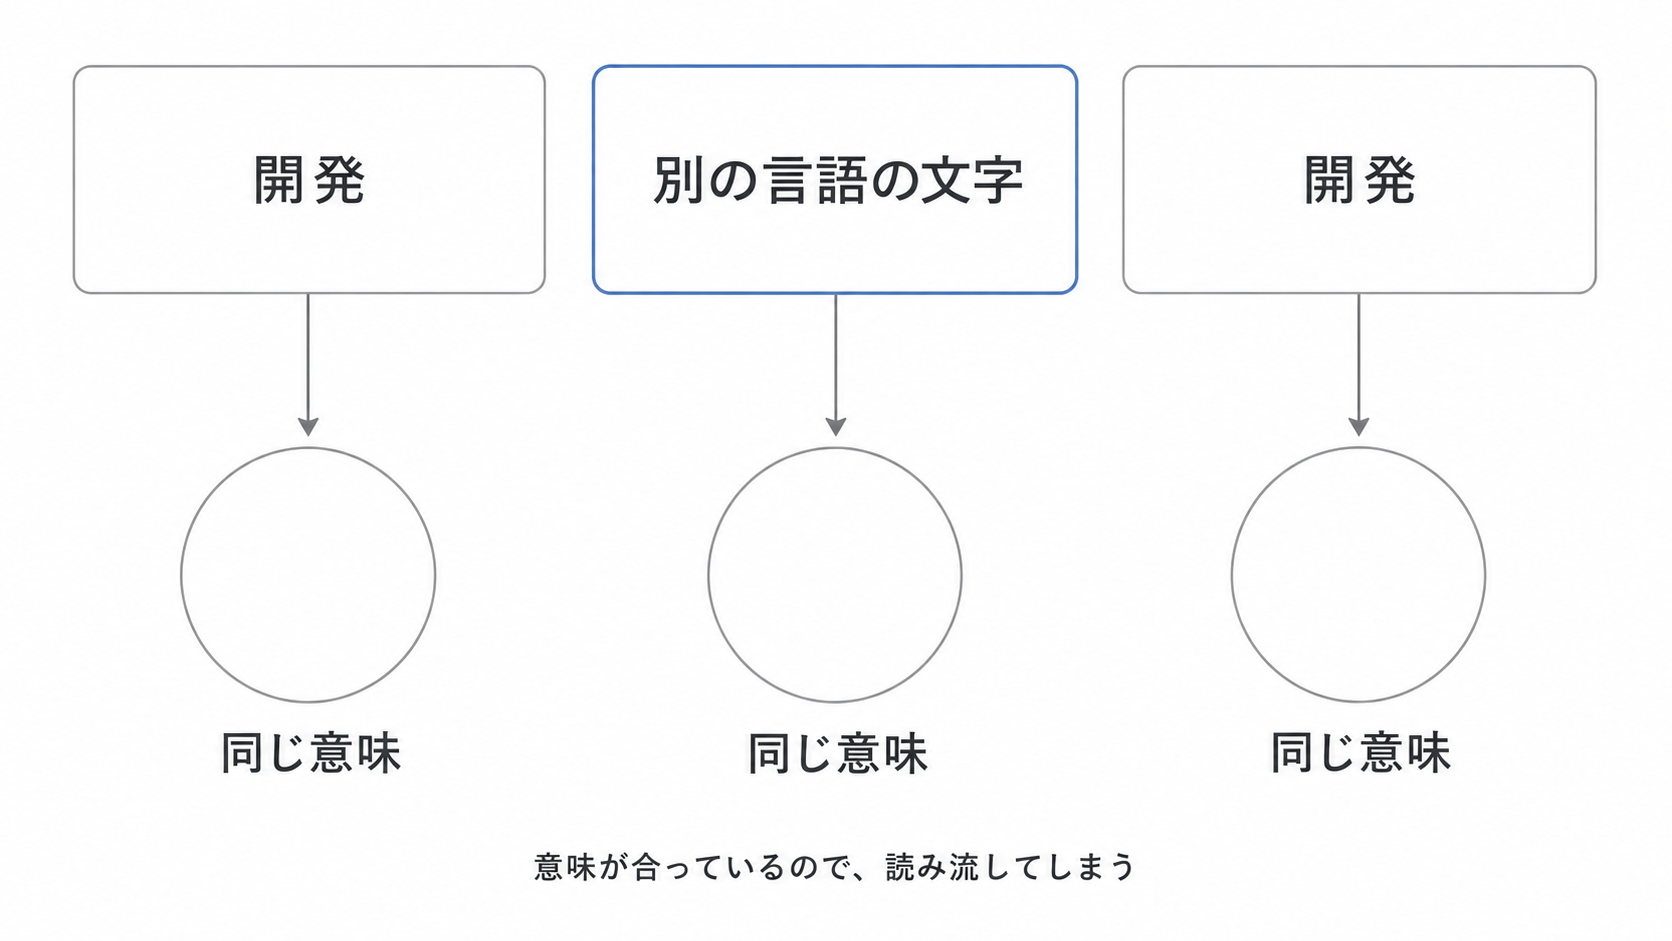
「개발」は韓国語で「開発」。 「устройства」はロシア語で「機器」。「안심」は韓国語で「安心」です。
意味は、全部合っています。 置かれている場所も正しい。文字だけが、日本語ではありません。
文字化けとは違います
ここが、この問題のややこしいところです。
文字化けなら、すぐ分かります。
縺薙l縺ッ髢狗匱縺ョ險倬鹸縺ァ縺意味をなさない記号が並ぶので、目が止まります。
今回のものは、読める文字で、意味も合っている。 引っかかる手がかりが、どこにもありません。
なぜ気づかないのか
意味が通っているからです。
「開発」と書いてあるべき場所に、「開発」という意味の何かがある。それを読んだとき、頭の中では「開発」と再生されます。
文字の形を、一つひとつ確かめていないんです。
人は、文字を見ていない
文章を読むとき、一文字ずつ確認しているわけではありません。
単語のかたまりを、形と文脈からまとめて把握しています。だから誤字を見落とすし、逆に多少崩れていても読めてしまう。
「こんちには」を「こんにちは」と読んでしまう、というのと同じ仕組みです。
書いた人ほど、見えない
これが、いちばん厄介でした。
他人の文章なら、たぶん気づきます。知らない内容なので、一つひとつ読むしかない。
自分の文章は、止まりません。 何が書いてあるか分かっているので、確認ではなく再生になります。
いちばん時間をかけて読んでいる人が、いちばん見えていない。
どこに出やすいか
自分が遭遇した範囲では、こういう場所でした。
単語ひとつだけ
文章全体が別言語になるのではありません。 単語1つが置き換わります。
前後は普通の日本語なので、流れが途切れません。
タグやカテゴリ
本文以外が、危ないです。
タグの並びに1つ混ざっていても、本文ほど注意して読みません。 自分の場合、ここで見つかったものがありました。
見出しの一部
見出しは短いので、かえって読み飛ばします。
自分で確認する方法
特別なツールは要りません。 パソコンに最初から入っているもので確認できます。
方法1:日本語の文字コードで保存してみる
これがいちばん確実です。
考え方は単純です。「日本語専用の保存形式」で保存しようとすると、日本語でない文字はエラーになります。
Macの場合
テキストエディットに文章を貼り付けて、こう操作します。
1. 「フォーマット」→「標準テキストにする」
2. 「ファイル」→「保存」
3. 「標準テキストのエンコーディング」で
   「日本語(Shift JIS)」を選ぶ
4. 保存を実行
日本語でない文字が入っていると、警告が出ます。 「この書類は指定したエンコーディングで保存できません」といった内容です。
Windowsの場合
メモ帳に貼り付けて、こう操作します。
1. 「ファイル」→「名前を付けて保存」
2. 「文字コード」で「ANSI」を選ぶ
3. 保存を実行
変換できない文字があると、警告のダイアログが出ます。
保存する必要はありません
警告が出るかどうかを見るだけです。実際に保存しなくてかまいません。
警告が出なければ、混入なし。 出たら、どこかに紛れています。
方法2:読み上げにかける
パソコンの読み上げ機能を使う方法もあります。
日本語の音声で読ませると、別の言語の部分でつまずきます。 読み飛ばされたり、おかしな音になったりする。
耳で聞くと、目で読むのとは違うところに気づきます。 誤字の発見にも効くので、習慣にすると一石二鳥です。
方法3:フォントを変えてみる
日本語のフォントには、他の言語の文字が入っていないことがあります。
その場合、その文字だけ別のフォントで表示されます。 太さや形が、周りと少し違って見える。
確実ではありませんが、眺めていて違和感があったら、そこを疑ってください。
見つけたら
その単語を、日本語で打ち直してください。
コピーして貼ると、また同じ文字が入ります。 見た目が似ていても別物なので、手で入力し直すのが確実です。
そして、同じ文章の中に他にもないか、もう一度確認してください。 1つ見つかったら、複数入っていることがあります。
完全には防げません
正直に書いておきます。
上の方法で見つかるのは、「日本語にない文字」だけです。
たとえば「這」「們」のような漢字は、中国語でよく使う字ですが、日本語にも存在します。 保存しても警告は出ません。
英語が混ざっている場合も、日本語の文章でアルファベットは普通に使うので、引っかかりません。
機械で見つかる分は見つけて、残りは目で見る。 そういう分担になります。
読み返し方を、少し変えました
この件があってから、やり方を変えたところがあります。
時間を空ける
書いた直後は、内容を覚えているので再生してしまいます。
一日置くと、少しだけ他人の文章に近づきます。それだけで、引っかかる回数が増えました。
声に出す
黙読だと、飛ばします。 声に出すと、一語ずつ通ることになります。
時間はかかりますが、目だけで読むより見つかります。
機械に任せるところを決める
人の目が苦手なところは、機械のほうが得意です。
文字コードの確認は、機械の仕事。内容が合っているかは、人の仕事。
そう分けると、読み返すときに何を見ればいいかがはっきりします。
まとめ
- AIが書いた日本語に、別の言語の文字が混ざることがある
- 文字化けとは違う。 読めるし、意味も合っている
- 気づかないのは、意味が通っているから
- 人は文字を一つずつ見ていない。書いた本人はとくに見えない
- 出やすいのは、単語ひとつ/タグやカテゴリ/見出し
- 確認は、日本語の文字コードで保存してみるのがいちばん確実
- Macは「日本語(Shift JIS)」、Windowsは「ANSI」を選ぶ
- 保存しなくていい。警告が出るかどうかを見るだけ
- 読み上げにかける、フォントを変える、という方法もある
- 見つけたら、コピーせずに打ち直す
- 完全には防げない。 日本語にもある漢字や、英語は引っかからない
三回読み返して気づかなかったものが、保存を試みた瞬間に見つかりました。
目で見つけるのが苦手なものは、たしかにあるんだと思います。
次回は、記号だけが違っている場合を扱います。これも、読んでもまず気づきません。